Bildungsgutschein schon parat? Beschleunige deine Bewerbung: Jetzt melden
Jetzt melden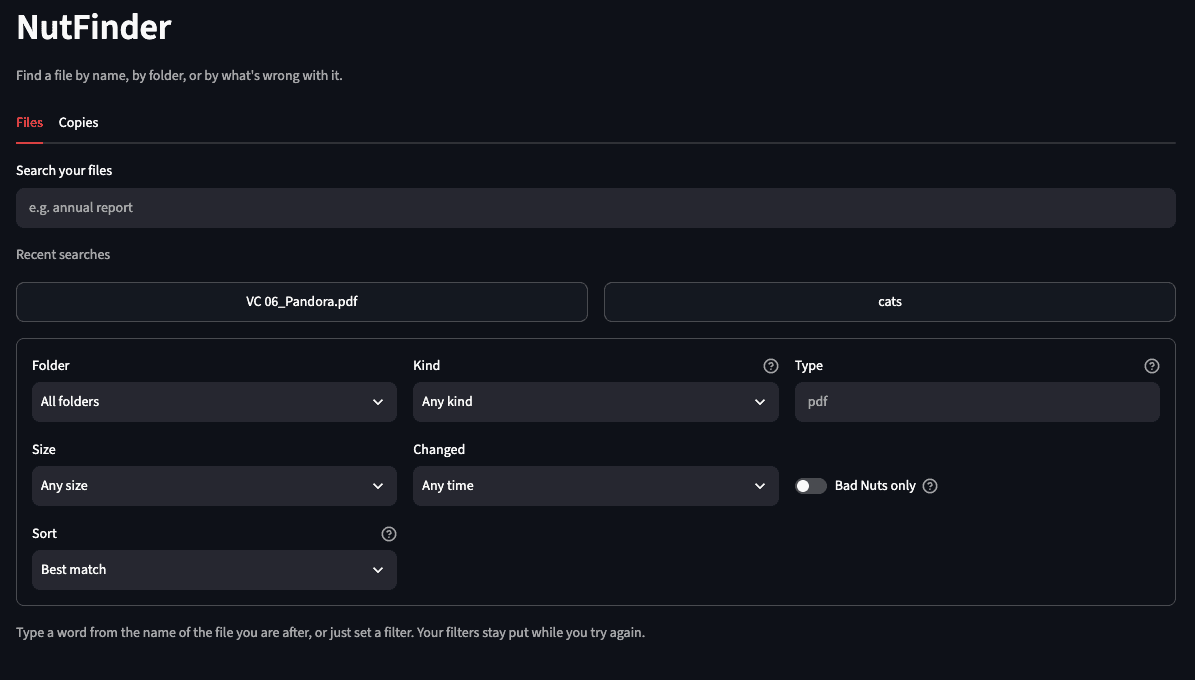
DataSquirrel
DataSquirrel ist selbstgehostete Datei-Intelligenz: Es indexiert den Speicher, auf den du es ansetzt – lokale Ordner, NAS-Freigaben und Google Drive – und lässt dich anschließend alles darin finden, ohne dass ein einziges Byte deinen Rechner verlässt.
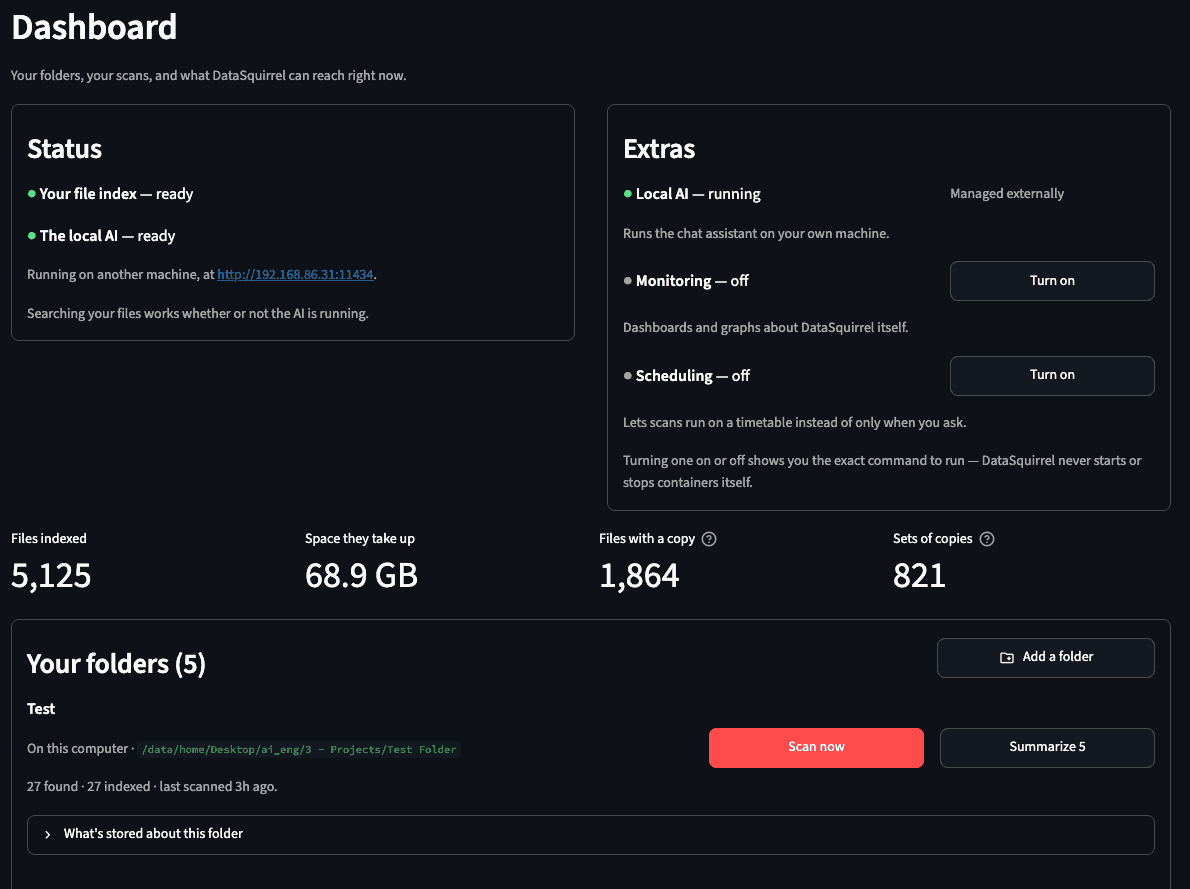
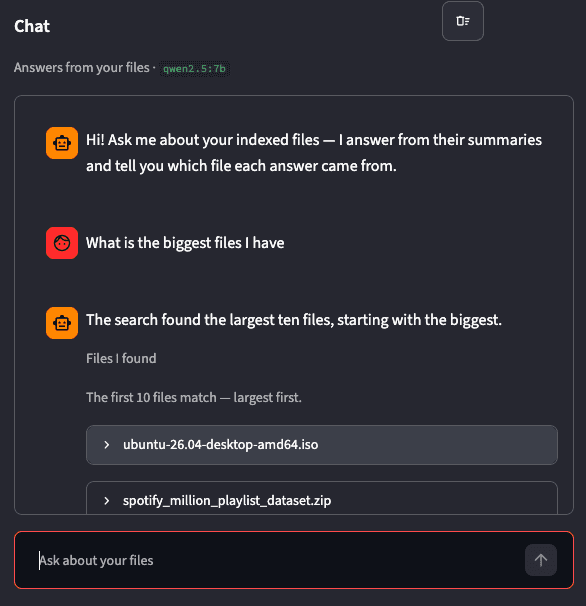
Richte es auf einen Ordner, und es durchsucht, hasht und katalogisiert jede gefundene Datei. Von dort aus sucht NutFinder nach Name und Metadaten und grenzt Ergebnisse nach Ordner, Art, Dateityp, Größe oder Datum ein; ein Duplikatbericht zeigt, was mehrfach gespeichert ist; eine Speicherübersicht zeigt, wohin der Platz tatsächlich gegangen ist. Auf Anforderung – niemals automatisch – liest und fasst ein lokales LLM eine Datei, eine Auswahl oder einen ganzen Ordner zusammen, und diese Zusammenfassungen werden neben den Dateinamen durchsuchbar. Ein Chat-Assistent in der Seitenleiste beantwortet Fragen zu deinen Dateien auf Basis dieser Zusammenfassungen, nennt die verwendeten Dateien als Beleg, sodass sich direkt zu ihnen springen lässt, und kann selbst eine gefilterte Suche ausführen: Frag nach deinen größten Videos aus diesem Jahr, und es ermittelt die passenden Filter. Ändert sich eine Datei, wird ihre Zusammenfassung als veraltet markiert statt stillschweigend überschrieben; verschwindet eine Datei, sagt DataSquirrel es dir, statt dir einen toten Pfad zu reichen.
Alles läuft in Docker auf deiner eigenen Hardware: ein FastAPI-Dienst und eine Streamlit-Oberfläche über PostgreSQL 16 mit Volltextsuche und pgvector, während Ollama das Modell bereitstellt. Kein Cloud-Dienst, kein Konto, keine Telemetrie. Eine einzige Codebasis läuft als Installation mit vier Containern auf einem Laptop oder ergänzt allein per Konfiguration GPU-Inferenz, geplante Scans und Monitoring – die Topologie ist eine Frage des Deployments, nie ein eigener Codepfad.
Privater und häuslicher Speicher verteilt sich über Laptops, externe Festplatten, ein NAS und Cloud-Konten – und ausgerechnet die Werkzeuge, die darin gut suchen, verlangen zuerst den Upload. Ziel von DataSquirrel ist es, dieselbe Suchqualität für Speicher zu bieten, den man selbst kontrolliert: Suche nach Dateiname und Metadaten, Inhaltszusammenfassungen auf Abruf und ein Chat-Assistent, der mit Quellenangaben antwortet – alles auf eigener Hardware, ohne Konto und ohne dass Daten den Rechner verlassen. Das zweite Ziel ist architektonisch: eine Codebasis, die sich als vier Container auf einem Laptop installieren lässt und allein über die Deployment-Konfiguration auf GPU-Inferenz, geplante Scans und Monitoring skaliert, niemals über verzweigten Code.
The Team
- Beatrice
Bea entwickelte das strukturierte Logging, das PostgreSQL-Integrationstest-Gerüst und die Ansicht zur Duplikatprüfung.
- Arsalan
Arsalan baute das Rückgrat des Backends – den FastAPI-Dienst, die Ingestion-Pipeline und die Orchestrierungsschicht.
- Saschsa
Sascha baute die Oberfläche: die App-Hülle, das Dashboard, NutFinder selbst sowie die Deduplizierungs-Engine und den Google-Drive-Konnektor.
- Niall
Niall verantwortete bei DataSquirrel die Architektur und die Ebene der Content-Intelligenz – das Datenbankschema, die Volltextsuche hinter NutFinder und den Chat-Assistenten, der die Dateien nennt, aus denen er antwortet.
We AI-proof
your career


