Bildungsgutschein schon parat? Beschleunige deine Bewerbung: Jetzt melden
Jetzt melden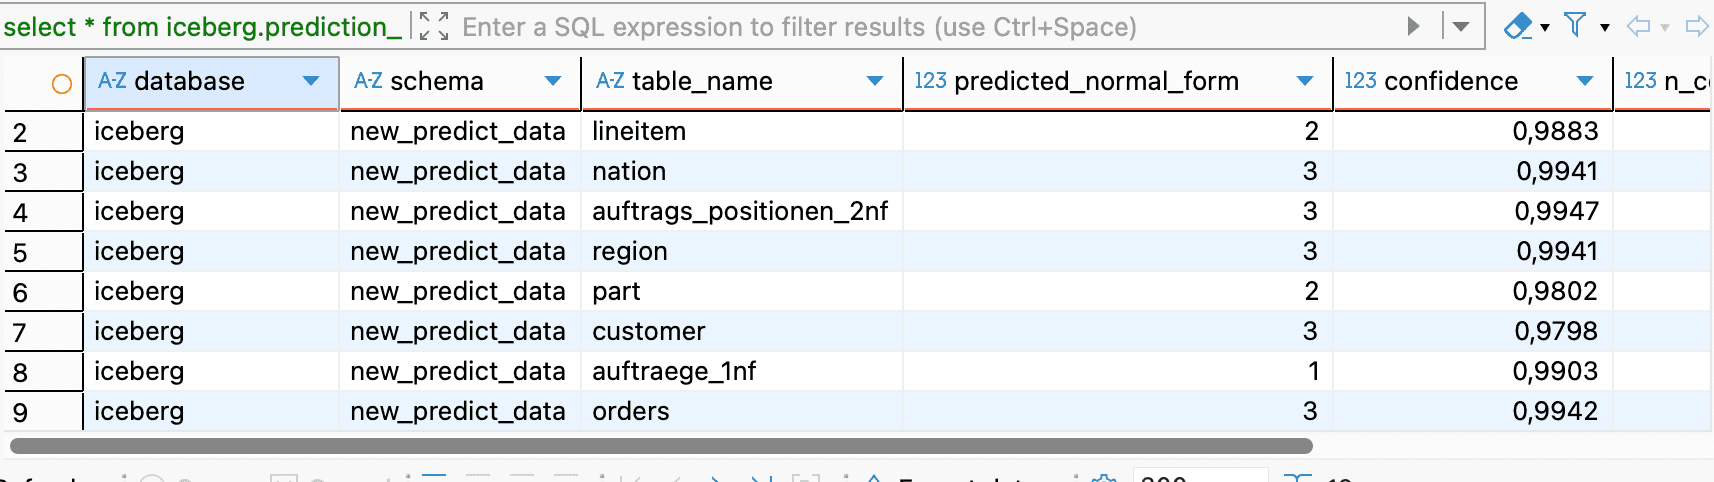
Alligator Metaswamp
Alligator Metaswamp ist ein ML-gestützter Dienst, der Eigenschaften von Datenbankschemata allein aus Metadaten vorhersagt – ohne Zugriff auf Zeilendaten. Er erkennt Primärschlüssel (einfach und zusammengesetzt), Fremdschlüssel (einfach und zusammengesetzt), Normalformen (0–3NF) und die Domänengruppierung (Themenbereiche) undokumentierter Datenbanken.
Das System ist um vier ML-Klassifikationsaufgaben herum aufgebaut, für die jeweils ein eigenes Modell entsteht: Erkennung einfacher und zusammengesetzter Primärschlüssel, Erkennung einfacher und zusammengesetzter Fremdschlüssel, Vorhersage der Normalform (0–3NF) und Ermittlung der Themenbereiche. Die Merkmale werden aus Datenbank-Metadaten und spaltenbezogenen Statistiken wie Kardinalität, Datentypen und Null-Mustern gebildet – niemals aus den tatsächlichen Datensätzen selbst.
Die Trainingsdaten umfassen über 60 öffentliche, synthetische und reale Datenbanken (Kaggle, TPC-H, Northwind, Spider, MIMIC-IV und weitere) aus Bereichen wie E-Commerce, Gesundheitswesen, Finanzen und Ingenieurwesen. Diese Breite sorgt dafür, dass die Modelle auf undokumentierte Altsysteme und Data-Lake-Importe verallgemeinern, und zwar ohne Compliance-Bedenken, da die Inferenz ausschließlich Metadaten berührt.
Der vollständige MLOps-Stack umfasst einen FastAPI-Dienst mit sechs typisierten Vorhersage-Endpunkten, eine MLflow-Registry für Modellversionierung und -freigabe, Prometheus und Grafana für das Monitoring der Golden Signals mit zehn Alarmregeln, Evidently zur Erkennung von Input-Drift sowie GitHub-Actions-CI mit Lint-, Format- und Testläufen.
Die Modelle nutzen mehrere Entscheidungsbaum-Klassifikatoren, trainiert mit gruppierter Kreuzvalidierung (nach Datenbank für Schlüssel, nach Tabelle für Normalformen), um Auswendiglernen zu verhindern. Der Dienst hält Modelle namensbasiert im Cache, und der gesamte Stack läuft aus einer einzigen Docker-Compose-Konfiguration. Das stützt den zentralen Anwendungsfall: Data Engineers erhalten nach Wahrscheinlichkeit bewertete, priorisierte Kandidaten zur Bestätigung, wenn sie Schlüssel für die Data-Vault-Modellierung rekonstruieren.
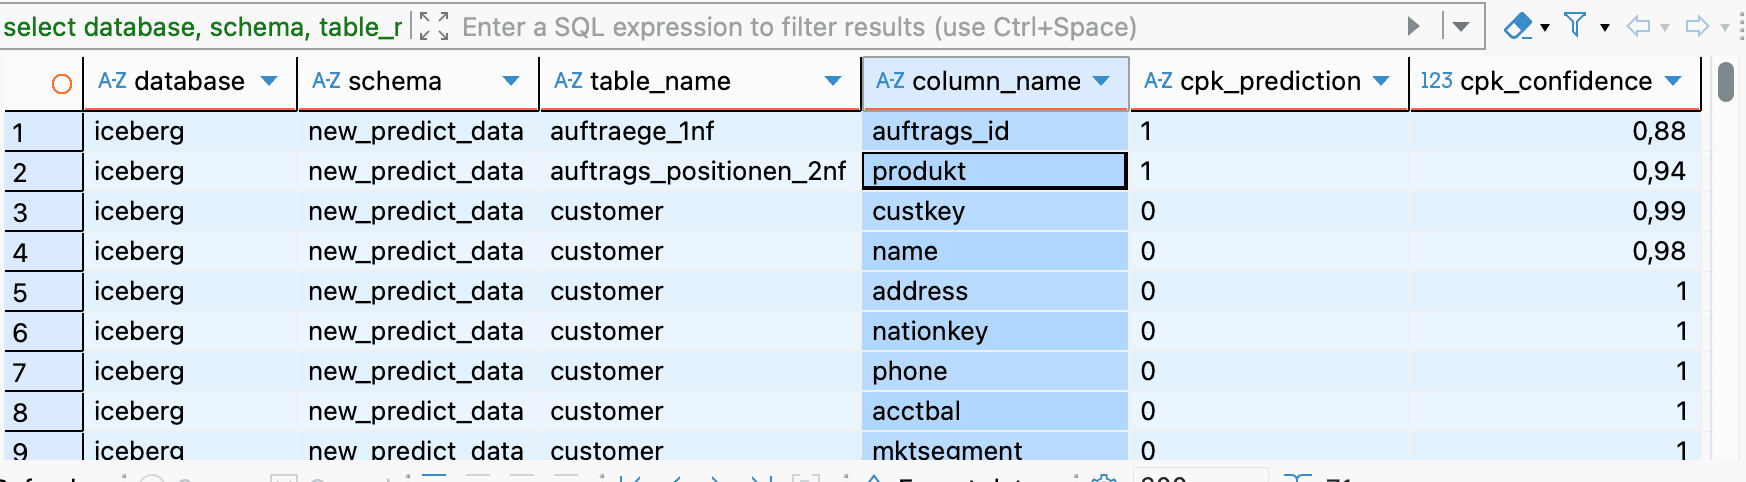
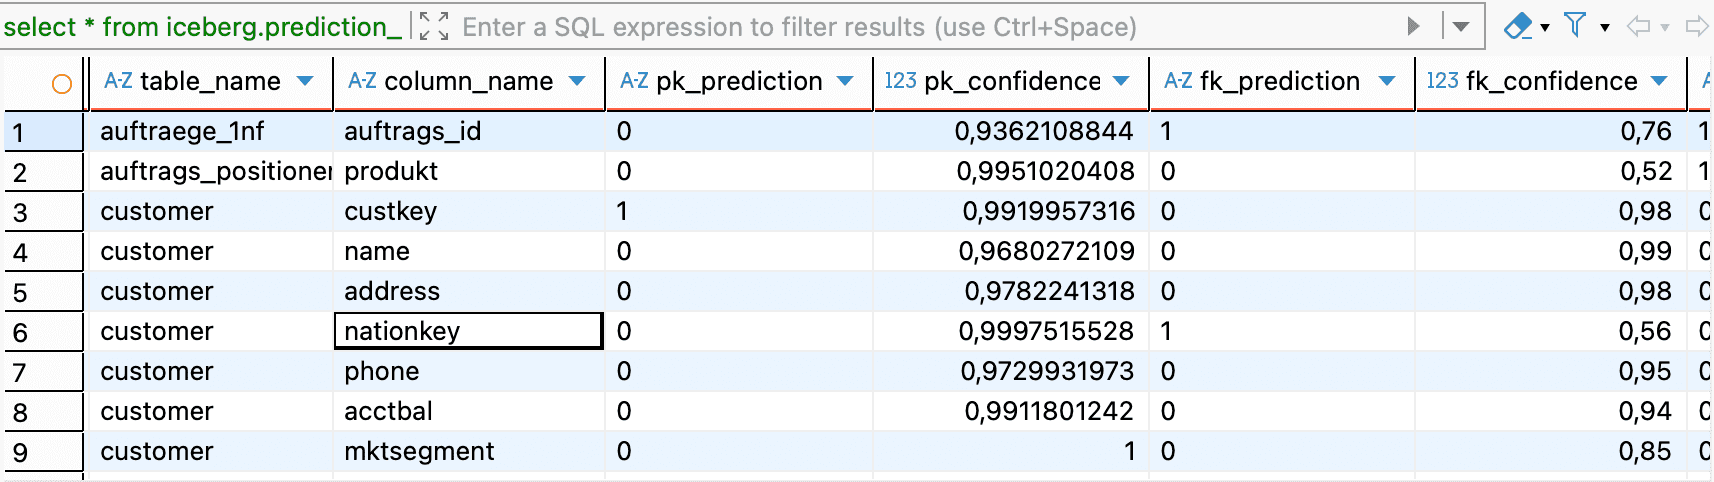
Halbautomatische Identifikation von Primärschlüsseln, Fremdschlüsseln, Normalformen und Themenbereichen, indem allein Datenbank-Metadaten analysiert und Fachleuten nach Wahrscheinlichkeit bewertete Kandidaten für Schemaeigenschaften vorgelegt werden. Beschleunigung von Datenmodellierungs-Workflows – insbesondere bei Data-Vault-Implementierungen –, bei denen Fachleute Vorhersagen bestätigen und verfeinern, statt bei null zu beginnen. Schnelle und regelkonforme Inferenz auf regulierten Daten (Medizin, Finanzen) ermöglichen. Aufbau eines produktionsreifen MLOps-Systems mit Experiment-Tracking, Modellversionierung, umfassendem Monitoring und CI/CD zur Sicherung von Modellqualität und Betriebssicherheit. Undokumentierte Altsysteme und Data-Lake-Bestände in gut verstandene, modellierte Datenbestände überführen.
The Team
- Christian Müller
Christian Müller: BI-Consultant, Data Engineer, Spezialist für Data Vault und Data Warehouse.
- Nijiati
Nijiati: Programmierer und Webentwickler, spezialisiert auf Java und Automatisierung.
- Niklas Lorenz
Niklas Lorenz: BI-Consultant, Data Engineer, Spezialist für Data Vault und Data Warehouse.
We AI-proof
your career


